Kubernetes上のGPUクラスタを監視するオープンソース運用ソフトの利用手順を公開
KubernetesとGPUの運用手順の概要
エヌビディアはKubernetes上のグラフィックス処理装置クラスタを構築、認定、監視するためのオープンソースの運用ソフトウェア群の利用手順を公開しました。
エラー情報や使用率の数値には表れにくい性能低下を起こしたノードを実際のワークロードから見つけ出す仕組みが特徴となっています。
構成の設定や稼働準備の認定などを担う複数のツールが提供されており、運用者がしきい値を設定することで性能に基づく合否判定を行います。
分散学習では全体の処理速度が遅い部分に合わせられるため、通信性能や事前学習モデルを用いた検証テストを実施することが重要になります。
監視ツールを導入すると、クラスタ内の状態を継続的に確認し、障害が検知されたノードに対してワークロードの退避や隔離、修復の自動対応を行えます。
変更管理や検証テストの連携機能を利用することで、ハードウェアの交換や更新を行った後でも一貫性を保った状態で運用を継続することが可能になります。
オープンソース監視ツールによる変更点
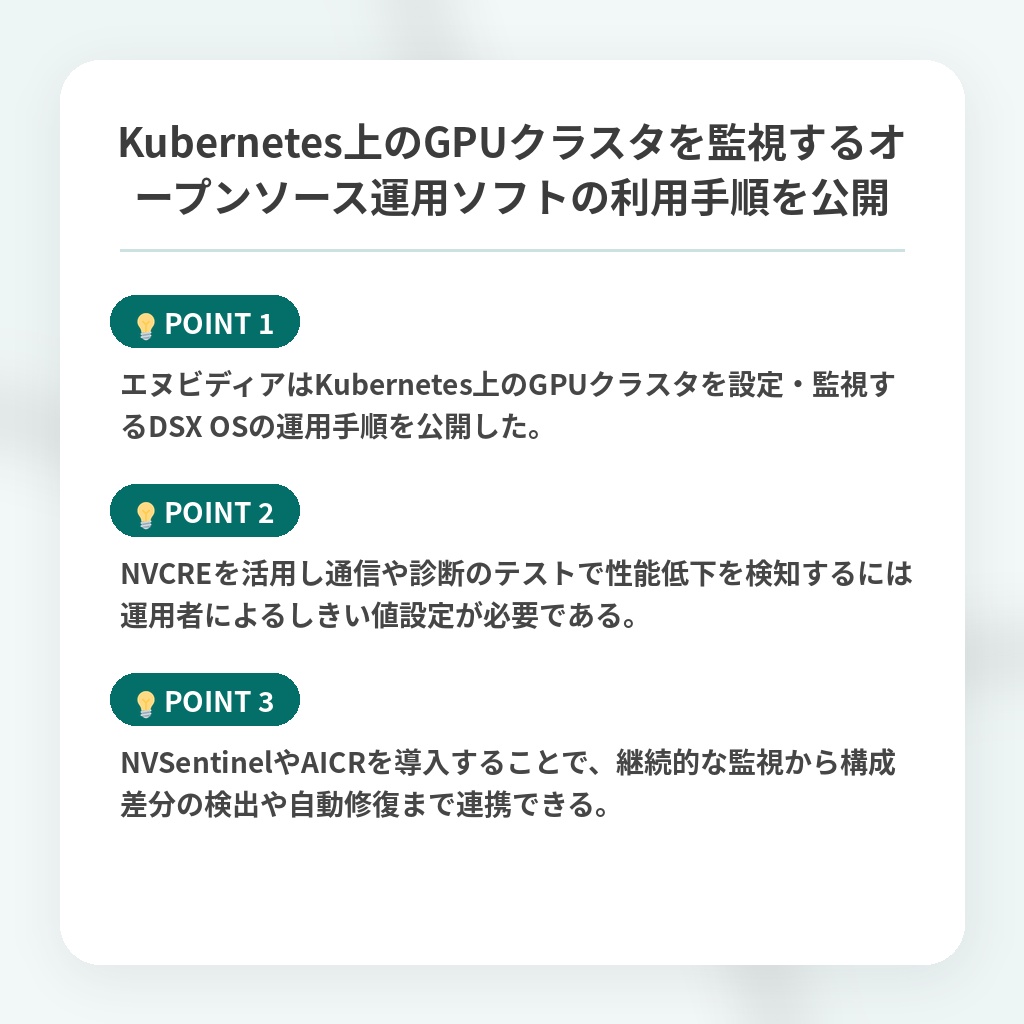
- エヌビディアはKubernetes上のGPUクラスタを設定・監視するDSX OSの運用手順を公開した。
- NVCREを活用し通信や診断のテストで性能低下を検知するには運用者によるしきい値設定が必要である。
- NVSentinelやAICRを導入することで、継続的な監視から構成差分の検出や自動修復まで連携できる。
クラスタ構築とソフトウェアの分析・解説
エヌビディアは、Kubernetes上のGPUクラスタを構築、認定、監視するためのオープンソースの運用ソフトウェア群「DSX OS」の利用手順を公開しました。
対象となるのは、NVIDIA AI Cluster Runtime(AICR)、NVIDIA Cluster Readiness Engine(NVCRE)、NVSentinelの3つのツールです。
AICRは構成の設定やバージョン固定のレシピ生成、構成のずれ検出を担います。
NVCREは分散ワークロードを実行し、NCCLの通信処理やDCGMの診断、事前学習モデルを用いた検証テストを実施します。
NVSentinelはGPUやネットワークの状態を監視し、障害時には自動対応を行います。
運用者は性能に基づく合否判定を行うために、しきい値を設定する必要があります。
初期状態ではしきい値が未設定のため、性能低下を起こしたノードを見逃す場合があります。
監視ツールや自動対応、修復後の再検証機能は、運用者が各機能を有効にする必要があります。
導入にはNVIDIA GPU OperatorやPrometheus Operatorのカスタムリソース定義などの前提条件があります。

まとめ
エヌビディアは、Kubernetes上のGPUクラスタを構築・監視するオープンソースの運用ソフトウェア群「DSX OS」の利用手順を公開しました。対象となるのは、構成設定を担うAICR、検証テストを行うNVCRE、状態監視と自動対応を行うNVSentinelの3ツールです。導入にあたっては、前提条件を確認し、運用者が性能の合否判定に向けたしきい値を設定する必要があります。詳細な仕様や前提条件をご確認ください。
関連トピックの詳細はこちら

出典・確認日
参照元:財経新聞:NVIDIA DSX OS、遅いGPUノードを性能テストで検出―初期設定ではしきい値の設定が必要
元記事公開日時:2026-11-07T22:36:17+09:00/参照元確認日:2026-11-08